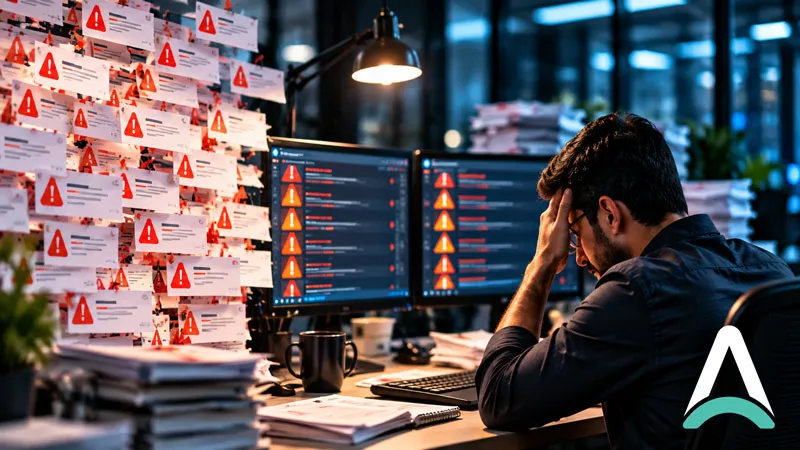
در یک زیرساخت کوچک، بررسی دستی هشدارهای شبکه شاید هنوز قابل مدیریت باشد. چند سرور، تعدادی تجهیزات شبکه و تعداد محدودی سرویس معمولاً حجم هشدار زیادی ایجاد نمی کنند و کارشناس می تواند Alertها را یکی یکی بررسی کند. اما با بزرگ تر شدن زیرساخت، شرایط کاملاً تغییر می کند. سرورها، ماشین های مجازی، تجهیزات شبکه، Storageها، سرویس های سازمانی، لینک های ارتباطی و ابزارهای مختلف مانیتورینگ شبکه به صورت مداوم وضعیت خود را گزارش می کنند. نتیجه می تواند ده ها یا صدها هشدار در بازه ای نسبتاً کوتاه باشد. در چنین محیطی، مسئله دیگر صرفاً دیدن هشدار نیست. تیم عملیات باید بتواند تشخیص دهد کدام هشدار مهم است، کدام هشدارها به یکدیگر مربوط هستند، چه کسی باید آن را بررسی کند و آیا مسئله تا زمان رفع کامل پیگیری شده است یا خیر. نامناسب بودن بررسی دستی هشدار شبکه دقیقاً در چنین شرایطی مشخص می شود؛ زمانی که حجم و پیچیدگی هشدارها از توان بررسی مؤثر و سریع توسط کارشناسان فراتر می رود.
چرا تعداد هشدارها در زیرساخت های سازمانی افزایش پیدا می کند؟
هرچه زیرساخت فناوری اطلاعات بزرگ تر و پیچیده تر شود، تعداد منابعی که باید مانیتور شوند نیز افزایش پیدا می کند. یک سازمان ممکن است به صورت هم زمان وضعیت موارد مختلفی مانند تجهیزات شبکه، سرورها، ماشین های مجازی، سرویس ها، پایگاه های داده، لینک های ارتباطی، فضای ذخیره سازی ابری، Backup Jobها، منابع پردازشی و سرویس های حیاتی کسب وکار را کنترل کند.
برای هرکدام از این موارد نیز چندین شاخص قابل مانیتور شدن وجود دارد. برای مثال فقط یک سرور می تواند برای CPU، RAM، Disk Space، Network Interface، Availability و چندین سرویس مختلف هشدار ایجاد کند. بنابراین افزایش تعداد Alertها الزاماً به معنی افزایش تعداد خرابی ها نیست؛ بخشی از آن نتیجه افزایش سطح مشاهده پذیری زیرساخت است. مشکل زمانی ایجاد می شود که سازمان داده و هشدار زیادی تولید کند، اما فرایند مناسبی برای مدیریت این حجم از اطلاعات نداشته باشد.
مشکل اصلی تعداد هشدارها نیست؛ نحوه مدیریت آنهاست
ممکن است تصور شود راه حل ساده این است که تعداد Alertها کاهش پیدا کند. اما حذف یا محدود کردن بیش از حد هشدارها نیز می تواند باعث کاهش Visibility شود. هدف صحیح این نیست که تیم NOC تا حد ممکن Alert کمتری دریافت کند؛ بلکه باید هشدارهای ایجادشده به شکلی مدیریت شوند که تیم بتواند از میان آنها رویدادهای مهم و قابل اقدام را سریع تشخیص دهد. برای رسیدن به این هدف، چند سؤال باید برای هر هشدار پاسخ داده شود:
- این هشدار چقدر مهم است؟
- چه سرویس یا بخشی از کسب وکار تحت تأثیر قرار گرفته است؟
- آیا هشدار مشابه یا تکراری است؟
- آیا چند Alert مختلف از یک مشکل مشترک ایجاد شده اند؟
- مسئول بررسی آن چه تیم یا فردی است؟
- آیا نیاز به Escalation دارد؟
- آیا برای آن Incident یا Ticket ایجاد شده است؟
- آیا مشکل واقعاً برطرف شده است؟
اگر پاسخ تمام این سؤال ها به بررسی دستی کارشناسان وابسته باشد، با افزایش تعداد هشدارها فرایند به سرعت با محدودیت روبه رو خواهد شد.
Alert Noise چیست؟
یکی از مشکلات رایج در محیط های مانیتورینگ، Alert Noise یا نویز هشدار است. Alert Noise زمانی اتفاق می افتد که تعداد زیادی هشدار ایجاد می شود اما همه آنها ارزش عملیاتی یکسانی ندارند. بخشی از آنها ممکن است تکراری، موقتی، کم اهمیت یا نتیجه یک مشکل مشترک باشند. فرض کنید ارتباط یک تجهیز اصلی شبکه قطع شود. این اتفاق ممکن است باعث شود ده ها Device یا Service وابسته نیز از دید سیستم مانیتورینگ Unreachable شوند. در ظاهر شاید ۵۰ هشدار مختلف ایجاد شده باشد، اما در واقع سازمان با 50 Incident مستقل روبه رو نیست. ممکن است تنها یک خرابی اصلی باعث ایجاد تمام این هشدارها شده باشد. اگر کارشناس مجبور باشد همه این موارد را به صورت مستقل بررسی کند، بخش قابل توجهی از زمان او صرف بررسی علائم یک مشکل خواهد شد، نه پیدا کردن و رفع علت اصلی.

Alert Fatigue؛ زمانی که هشدارها دیگر توجه ایجاد نمی کنند
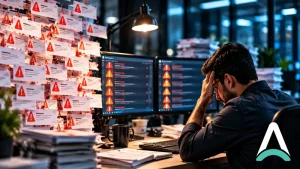
مشکل مهم تر، Alert Fatigue یا خستگی ناشی از هشدار است. زمانی که کارشناسان به طور مداوم با تعداد زیادی Alert مواجه شوند، به خصوص اگر بخش زیادی از آنها تکراری، کم اهمیت یا غیرقابل اقدام باشند، حساسیت نسبت به هشدارها کاهش پیدا می کند. در چنین شرایطی ممکن است یک Alert واقعاً Critical در میان تعداد زیادی Warning و Notification عادی دیده نشود یا دیرتر از زمان مناسب بررسی شود. بنابراین Alert Fatigue فقط مسئله ای مربوط به راحتی کارشناسان نیست. این وضعیت می تواند مستقیماً بر کیفیت پاسخ گویی به Incidentها اثر بگذارد.
چرا بررسی دستی Alertها در مقیاس بالا قابل اتکا نیست؟
- همه هشدارها ارزش یکسانی ندارند
بالا رفتن CPU یک سرور برای چند دقیقه با Down شدن یک سرویس حیاتی سازمان اهمیت یکسانی ندارد. اگر هر دو صرفاً به شکل یک Alert در داشبورد نمایش داده شوند، تشخیص اهمیت آنها بر عهده کارشناس قرار می گیرد. در محیطی با صدها هشدار، انجام این اولویت بندی به صورت دستی هم زمان بر است و هم احتمال خطا دارد.
- یک Incident می تواند چندین Alert ایجاد کند:
در زیرساخت های وابسته، خرابی یک Component ممکن است روی چندین سرویس دیگر اثر بگذارد. برای مثال قطع یک لینک، خرابی یک Switch یا مشکل در یک Hypervisor ممکن است تعداد زیادی هشدار ثانویه ایجاد کند. در این شرایط باید ارتباط میان Alertها شناسایی شود تا کارشناسان به جای بررسی تک تک نشانه ها، روی Incident اصلی تمرکز کنند.
- احتمال دیده نشدن هشدار مهم افزایش پیدا می کند:
وقتی داشبورد دائماً با هشدارهای جدید پر می شود، Critical Alert عملاً برای جلب توجه با ده ها هشدار دیگر رقابت می کند. هرچه نسبت هشدارهای کم اهمیت به هشدارهای واقعی بیشتر شود، احتمال اینکه یک رویداد مهم دیر تشخیص داده شود نیز افزایش پیدا می کند.
- فرایند به حافظه و دقت افراد وابسته می شود:
در یک مدل دستی، کارشناس باید Alert را ببیند، اهمیت آن را تشخیص دهد، تیم مسئول را پیدا کند، اطلاع رسانی کند و بعداً بررسی کند که مشکل رفع شده است یا خیر. اگر این مراحل در یک Workflow مشخص ثبت نشوند، فرایند به حافظه افراد وابسته خواهد شد. در نتیجه ممکن است هشدار دیده شده باشد، اما پیگیری نشده باشد؛ یا برای فردی ارسال شده باشد، اما مشخص نباشد چه کسی مسئول نهایی آن است.
- تحویل شیفت می تواند باعث گم شدن مسائل باز شود:
این مسئله در NOCهای 24×7 اهمیت بیشتری دارد. ممکن است یک Alert در انتهای شیفت ایجاد شود، کارشناس بررسی اولیه را انجام دهد و موضوع هنوز باز باشد. اگر وضعیت آن به صورت ساختاریافته ثبت نشده باشد، تیم شیفت بعدی باید دوباره موضوع را بررسی کند یا حتی ممکن است از وجود آن مطلع نشود. بنابراین مدیریت Alert باید مستقل از حافظه و ارتباط شفاهی افراد باشد.
آیا ساخت خودکار Ticket برای هر Alert راه حل است؟
نه لزوماً. یکی از اشتباهات رایج این است که تصور شود با اتصال ابزار Monitoring به سیستم Ticketing مشکل حل خواهد شد. اگر برای هر Alert به صورت خودکار یک Ticket ایجاد شود، ممکن است مشکل Alert Noise صرفاً به Ticket Noise منتقل شود. برای مثال اگر یک خرابی ۳۰ Alert مرتبط ایجاد کند و برای هرکدام یک Ticket مستقل ساخته شود، تیم عملیات اکنون علاوه بر ۳۰ Alert با ۳۰ Ticket نیز روبه رو خواهد شد. بنابراین قبل از ایجاد Ticket باید مشخص شود:
Alert → آیا قابل اقدام است؟ → آیا تکراری است؟ → آیا با Alert دیگری مرتبط است؟ → Severity آن چیست؟ → مسئول آن کیست؟ → آیا نیاز به Ticket دارد؟
اتوماسیون زمانی مفید است که منطق عملیاتی پشت آن وجود داشته باشد.

Alert Correlation چه نقشی دارد؟
یکی از راهکارهای مهم برای مدیریت حجم زیاد هشدارها، Alert Correlation است. در این روش، سیستم تلاش می کند هشدارهایی را که احتمالاً به یک رویداد مشترک مربوط هستند شناسایی و در قالب یک Incident منطقی گروه بندی کند. برای مثال ممکن است این هشدارها تقریباً هم زمان ایجاد شوند:
- Router Unreachable
- Switch Unreachable
- Server Ping Failed
- Application Unavailable
بررسی جداگانه این چهار هشدار ممکن است چهار مسیر عیب یابی ایجاد کند. اما اگر مشخص شود تمام آنها پس از قطع یک لینک WAN ایجاد شده اند، تیم عملیات می تواند مستقیماً روی علت اصلی تمرکز کند. هدف Correlation حذف اطلاعات نیست؛ هدف تبدیل مجموعه ای از Signalهای پراکنده به اطلاعاتی قابل فهم برای تصمیم گیری است.
اولویت بندی هشدارها باید چگونه انجام شود؟
Severity فنی به تنهایی همیشه معیار کافی برای تعیین اولویت نیست. فرض کنید دو سرور Down شده اند. یکی مربوط به یک محیط آزمایشی است و دیگری سرویس اصلی مشتریان را اجرا می کند. از نظر Monitoring ممکن است هر دو Critical باشند، اما از نظر کسب وکار اولویت یکسانی ندارند. بنابراین یک سیستم مدیریت Alert مناسب باید علاوه بر وضعیت فنی، اطلاعات دیگری مانند اهمیت سرویس، وابستگی ها، زمان وقوع، دامنه اثر و SLA را نیز در تصمیم گیری وارد کند. در واقع سؤال مهم فقط این نیست که چه چیزی خراب شده است؟ بلکه باید پرسید: این خرابی چه اثری دارد و با چه اولویتی باید رسیدگی شود؟
از مانیتورینگ تا مدیریت رخداد
Monitoring فقط مرحله تشخیص است. زمانی که سیستم Monitoring یک مشکل را شناسایی می کند، تازه فرایند عملیاتی شروع می شود. همین موضوع یکی از مهم ترین تفاوت های مانیتورینگ شبکه با مرکز عملیات شبکه است؛ مانیتورینگ بر مشاهده وضعیت و شناسایی مشکل تمرکز دارد، در حالی که NOC فرایند رسیدگی به رخداد، تعیین مسئول، پیگیری، Escalation و رفع مشکل را نیز در بر می گیرد. یک جریان کامل می تواند به شکل زیر باشد: Detection → Validation → Prioritization → Assignment → Notification → Ticketing → Escalation → Resolution → Reporting
در این مدل، Alert نقطه شروع فرایند است، نه پایان آن. اگر سازمان فقط ابزار Monitoring داشته باشد اما فرایند مشخصی برای مراحل بعدی وجود نداشته باشد، حتی بهترین ابزار مانیتورینگ نیز نمی تواند تضمین کند که مشکل در زمان مناسب رفع خواهد شد.
اتوماسیون مدیریت هشدار دقیقاً چه کارهایی را باید انجام دهد؟
اتوماسیون مناسب قرار نیست تصمیم گیری انسانی را به طور کامل حذف کند. هدف این است که کارهای تکراری و قابل پیش بینی از دوش کارشناسان برداشته شوند. برای مثال می توان بخشی از فرایندهای زیر را خودکار کرد:
- دریافت Alert از ابزارهای Monitoring
- حذف یا تشخیص هشدارهای تکراری
- Correlation هشدارهای مرتبط
- تعیین Severity و Priority
- شناسایی سرویس یا تجهیز تحت تأثیر
- تعیین تیم مسئول
- ارسال Notification
- ایجاد Ticket در شرایط مشخص
- Escalation در صورت عدم پاسخ
- ثبت تغییرات وضعیت
- پیگیری تا زمان Resolve
- جمع آوری داده برای گزارش های مدیریتی
در این معماری، کارشناس به جای اینکه زمان خود را صرف جابه جایی اطلاعات میان چند ابزار کند، روی تحلیل و حل مسئله تمرکز می کند.

نقش هوش مصنوعی در مدیریت هشدارهای شبکه چیست؟
هوش مصنوعی و AIOps می توانند در محیط هایی که حجم داده و Alert زیاد است به تحلیل سریع تر اطلاعات کمک کنند. برای مثال سیستم های پیشرفته می توانند از داده های تاریخی برای تشخیص رفتار عادی زیرساخت، شناسایی Anomaly، Correlation رویدادها، کاهش False Positiveها یا کمک به Root Cause Analysis استفاده کنند. اما استفاده از AI به تنهایی راه حل مسئله نیست. اگر Thresholdها نامناسب باشند، داده های ورودی کیفیت کافی نداشته باشند یا Workflow پاسخ به Incident مشخص نباشد، اضافه کردن AI صرفاً یک لایه فناوری دیگر به یک فرایند ضعیف اضافه می کند. بنابراین ابتدا باید فرایند مدیریت هشدار طراحی شود و سپس از AI برای هوشمندتر کردن بخش های مناسب آن استفاده کرد.
چگونه بفهمیم مدیریت دستی Alertها دیگر جواب نمی دهد؟
تعداد Alert به تنهایی معیار مناسبی نیست. ممکن است یک سازمان روزانه صدها Alert داشته باشد اما بخش زیادی از آنها به صورت خودکار مدیریت شوند؛ در مقابل سازمان دیگری با تعداد بسیار کمتری Alert، فرایند ناکارآمدی داشته باشد.
چند نشانه مهم وجود دارد:
- کارشناسان مرتباً داشبورد Monitoring را برای پیدا کردن Alertهای مهم بررسی می کنند.
- هشدارهای تکراری حجم زیادی از صفحه Monitoring را اشغال می کنند.
- مشخص نیست مسئول رسیدگی به بعضی Alertها چه کسی است.
- برای پیگیری مشکلات از تماس، پیام رسان و Ticket به صورت پراکنده استفاده می شود.
- بعضی Incidentها با تأخیر شناسایی یا Escalate می شوند.
- در زمان تحویل شیفت، وضعیت مسائل باز باید به صورت شفاهی منتقل شود.
- تهیه گزارش عملکرد NOC نیازمند جمع آوری دستی اطلاعات است.
- تعداد زیادی Alert بدون اقدام مشخص بسته یا نادیده گرفته می شوند.
وجود چند مورد از این نشانه ها معمولاً نشان می دهد مشکل دیگر ابزار Monitoring نیست؛ بلکه فرایند Alert Management نیاز به بازطراحی دارد.
یک NOC مدرن باید به جای دیدن Alert چه کاری انجام دهد؟
هدف یک مرکز عملیات شبکه مدرن نباید صرفاً نمایش وضعیت تجهیزات باشد. مرکز عملیات شبکه NOC باید بتواند فاصله بین تشخیص مشکل و اقدام برای رفع آن را مدیریت کند.به عبارت دیگر، یک فرایند بالغ باید بتواند به صورت شفاف مشخص کند:
- چه اتفاقی افتاده؟
- چقدر مهم است؟
- چه چیزی تحت تأثیر قرار گرفته؟
- چه کسی مسئول آن است؟
- چه اقدامی انجام شده؟
- و آیا مسئله واقعاً برطرف شده است؟
این تغییر نگاه، تفاوت میان «مانیتورینگ زیرساخت» و «مدیریت عملیات» را مشخص می کند.

چه شاخص هایی برای ارزیابی مدیریت هشدارها مهم هستند؟
برای ارزیابی عملکرد NOC بهتر است فقط تعداد Alertها اندازه گیری نشود. شاخص های عملیاتی اطلاعات بسیار مفیدتری ارائه می کنند .از جمله:
- متوسط زمان لازم برای تشخیص یک
- مدت زمانی که طول می کشد تا تیم مسئول هشدار را دریافت و تأیید کند.
- متوسط زمان لازم برای رفع
همچنین می توان نرخ False Positive، تعداد Alertهای تکراری، تعداد Incidentهای Escalate شده، Alertهای بدون Owner و تعداد مشکلات تکرارشونده را نیز بررسی کرد. این شاخص ها کمک می کنند کیفیت واقعی فرایند عملیات قابل اندازه گیری شود.
جمع بندی
افزایش تعداد Alertها نتیجه طبیعی رشد و پیچیده تر شدن زیرساخت های فناوری اطلاعات است. مسئله اصلی این نیست که سازمان هشدارهای زیادی دریافت می کند؛ مسئله این است که آیا می تواند این حجم از اطلاعات را به اقدام عملیاتی تبدیل کند یا خیر. بررسی دستی Alertها در محیط های کوچک ممکن است همچنان قابل استفاده باشد، اما با افزایش تعداد تجهیزات، سرویس ها و وابستگی ها، اتکا به بررسی انسانی تک تک هشدارها احتمال تأخیر، خطا، Alert Fatigue و گم شدن Incidentهای مهم را افزایش می دهد. راه حل نیز صرفاً کاهش تعداد Alert یا ایجاد خودکار Ticket برای همه آنها نیست. معماری مناسب باید بتواند هشدارها را اعتبارسنجی، اولویت بندی و Correlate کند، مسئول رسیدگی را مشخص کند و فرایند را از لحظه تشخیص تا رفع کامل Incident قابل پیگیری نگه دارد. در چنین مدلی، فناوری جای کارشناس NOC را نمی گیرد؛ بلکه حجم کار تکراری را کاهش می دهد تا نیروی انسانی بتواند روی بخشی تمرکز کند که بیشترین ارزش را ایجاد می کند: تحلیل، تصمیم گیری و رفع مسئله.
سوالات متداول درباره نامناسب بودن بررسی دستی هشدار شبکه
- Alert Fatigue چیست؟
Alert Fatigue زمانی ایجاد می شود که کارشناسان به دلیل مواجهه مداوم با تعداد زیادی هشدار، به خصوص هشدارهای کم اهمیت یا تکراری، حساسیت خود را نسبت به آنها از دست بدهند. این مسئله می تواند باعث تأخیر در شناسایی Alertهای مهم شود. - آیا باید تعداد Alertهای شبکه را کاهش دهیم؟
نه لزوماً. هدف اصلی باید افزایش کیفیت و قابلیت اقدام روی Alertها باشد. حذف بیش از حد هشدارها ممکن است Visibility زیرساخت را کاهش دهد. بهتر است هشدارها اولویت بندی، دسته بندی و Correlate شوند. - Alert Correlation چیست؟
Alert Correlation فرایندی است که در آن هشدارهای مرتبط با یکدیگر شناسایی و گروه بندی می شوند تا مشخص شود آیا چند Alert مختلف در واقع ناشی از یک Incident یا Root Cause مشترک هستند. - آیا برای هر Alert باید Ticket ایجاد شود؟
خیر. ایجاد Ticket برای تمام Alertها می تواند حجم زیادی Ticket غیرضروری ایجاد کند. بهتر است ابتدا اهمیت، ارتباط، تکراری بودن و قابلیت اقدام روی Alert بررسی شود و سپس در صورت نیاز Ticket ایجاد شود. - آیا هوش مصنوعی می تواند مدیریت Alertها را کاملاً خودکار کند؟
در برخی مراحل مانند Correlation، تشخیص Anomaly، اولویت بندی و تحلیل داده های تاریخی می توان از AI استفاده کرد، اما در Incidentهای پیچیده یا حساس همچنان تصمیم گیری انسانی اهمیت دارد. مدل مناسب معمولاً ترکیبی از اتوماسیون و نظارت انسانی است. - تفاوت Monitoring و Alert Management چیست؟
Monitoring وضعیت زیرساخت را مشاهده و مشکلات احتمالی را شناسایی می کند. Alert Management مشخص می کند با هشدار ایجادشده چه اتفاقی باید بیفتد؛ از اولویت بندی و تعیین مسئول گرفته تا Notification، Escalation، Ticketing و پیگیری تا زمان رفع مشکل.