اختلال در زیرساخت فناوری اطلاعات همیشه به معنای خرابی یک سرور نیست. قطعی برق دیتاسنتر، خرابی تجهیزات ذخیره سازی، حملات باج افزاری، اختلالات شبکه یا حتی اشتباهات انسانی می توانند چندین سرویس حیاتی سازمان را به صورت هم زمان از دسترس خارج کنند. در چنین شرایطی، داشتن نسخه پشتیبان از اطلاعات به تنهایی کافی نیست. سازمان باید بتواند سرویس های خود را در یک زیرساخت جایگزین و در زمان مشخص بازیابی کند. مجازی سازی (Virtualization) یکی از فناوری های کلیدی برای تحقق این هدف است. این فناوری با کاهش وابستگی سیستم عامل ها و نرم افزارها به سخت افزار فیزیکی، امکان انتقال، تکثیر و بازیابی ماشین های مجازی را در سایت پشتیبان فراهم می کند. اما مجازی سازی دقیقاً چه نقشی در بازیابی بحران دارد؟ چگونه می توان با استفاده از آن یک سایت DR طراحی کرد و چه زیرساخت هایی برای اجرای موفق این فرایند مورد نیاز است؟ در ادامه، این موضوع را از جنبه معماری، پیاده سازی، مزایا و چالش های فنی بررسی می کنیم.
سایت بازیابی بحران (DR Site) چیست؟
سایت بازیابی بحران یا Disaster Recovery Site یک زیرساخت جایگزین است که در صورت بروز اختلال جدی در دیتاسنتر اصلی، امکان ادامه فعالیت سرویس های حیاتی سازمان را فراهم می کند. این سایت می تواند در یک دیتاسنتر دیگر، موقعیت جغرافیایی مستقل یا زیرساخت ابری قرار داشته باشد. هدف اصلی سایت DR، صرفاً نگهداری اطلاعات نیست؛ بلکه بازیابی سرویس ها و بازگرداندن عملیات سازمان در محدوده زمانی و سطح ازدست رفتن داده قابل قبول است.
برای مثال، فرض کنید سامانه مالی یک سازمان روی چندین سرور شامل وب سرور، سرور برنامه و پایگاه داده اجرا می شود. اگر دیتاسنتر اصلی از دسترس خارج شود، بازیابی صرفاً یکی از این سرورها کافی نخواهد بود. سایت DR باید بتواند مجموعه سرویس های وابسته را با ترتیب صحیح، تنظیمات شبکه مناسب و داده های سازگار بازیابی کند تا سامانه مجدداً قابل استفاده باشد.
تفاوت سایت DR با بکاپ چیست؟
بکاپ (Backup) و بازیابی بحران دو مفهوم مرتبط اما متفاوت هستند. بکاپ برای تهیه نسخه قابل بازیابی از اطلاعات استفاده می شود؛ درحالی که DR مجموعه ای از زیرساخت ها، فرایندها و ابزارهاست که امکان بازیابی سرویس های عملیاتی را پس از بحران فراهم می کند.
| معیار | بکاپ | سایت بازیابی بحران |
| هدف اصلی | حفاظت و بازیابی اطلاعات | ادامه فعالیت سرویس ها |
| زیرساخت جایگزین | الزاماً ندارد | نیازمند ظرفیت اجرای سرویس هاست |
| زمان بازیابی | وابسته به حجم داده و روش بازیابی | بر اساس RTO طراحی می شود |
| بازیابی سیستم عامل و سرویس | بسته به نوع بکاپ | بخشی از برنامه بازیابی است |
| کاربرد | حذف اطلاعات، خرابی فایل، آلودگی داده | اختلال گسترده یا از دست رفتن سایت اصلی |
نکته مهم این است که Replication نیز جایگزین کامل بکاپ نیست. اگر اطلاعات در سایت اصلی حذف یا رمزگذاری شوند، ممکن است این تغییرات به سایت DR منتقل شوند. به همین دلیل، یک معماری اصولی باید علاوه بر Replication، از نسخه های پشتیبان مستقل، محافظت شده و قابل بازیابی استفاده کند.
پیاده سازی سایت بازیابی بحران با امین دقیق سامانه
طراحی و پیاده سازی سایت DR نیازمند شناخت دقیق زیرساخت، انتخاب معماری مناسب و یکپارچه سازی فناوری های مجازی سازی، ذخیره سازی، شبکه و پشتیبان گیری است. امین دقیق سامانه با ارائه خدمات تخصصی زیرساخت و مجازی سازی، به سازمان ها در ارزیابی وضعیت موجود، طراحی معماری بازیابی بحران، پیاده سازی راهکارهای Replication و تدوین و آزمایش سناریوهای بازیابی کمک می کند. برای بررسی زیرساخت سازمان و انتخاب راهکار مناسب بازیابی بحران، می توانید از خدمات مشاوره تخصصی امین دقیق سامانه استفاده کنید.
مجازی سازی چه نقشی در بازیابی بحران دارد؟
در زیرساخت های سنتی، بسیاری از سرویس ها مستقیماً روی سرورهای فیزیکی نصب می شوند. در این ساختار، بازیابی یک سرور آسیب دیده ممکن است نیازمند تهیه سخت افزار مشابه، نصب سیستم عامل، پیکربندی نرم افزارها و بازگرداندن اطلاعات باشد. این وابستگی می تواند زمان بازیابی را افزایش دهد. مجازی سازی با ایجاد یک لایه انتزاعی میان سخت افزار و سیستم عامل، این محدودیت را تا حد زیادی کاهش می دهد. در محیط مجازی، سرورها به شکل ماشین مجازی (Virtual Machine) اجرا می شوند. هر ماشین مجازی شامل سیستم عامل، تنظیمات و دیسک های مجازی است و می توان آن را با استفاده از ابزارهای مناسب به زیرساخت دیگری منتقل یا در آن بازیابی کرد. این قابلیت چند مزیت مهم برای طراحی سایت DR ایجاد می کند.
1. کاهش وابستگی به سخت افزار فیزیکی
یکی از مهم ترین مزایای مجازی سازی، کاهش وابستگی سرویس ها به مدل مشخصی از سرورهای فیزیکی است. برای مثال، ممکن است ماشین مجازی یک سازمان روی سرور Dell اجرا شود، اما در صورت خرابی دیتاسنتر اصلی، روی یک سرور HPE در سایت پشتیبان بازیابی شود؛ مشروط بر اینکه زیرساخت مجازی سازی، پردازنده ها و سایر اجزای مورد نیاز با یکدیگر سازگار باشند. به این ترتیب، سازمان برای بازیابی هر سرویس الزاماً به یک سرور فیزیکی کاملاً مشابه نیاز ندارد.
2. تسریع فرایند بازیابی سرویس ها
- در محیط مجازی، در صورت وجود Replication مناسب، داده ها و تنظیمات ماشین های مجازی از قبل در سایت پشتیبان آماده خواهند بود.
- هنگام وقوع بحران، به جای نصب مجدد سیستم عامل و نرم افزارها، می توان ماشین های مجازی را مطابق برنامه بازیابی در زیرساخت جایگزین راه اندازی کرد.
- البته سرعت نهایی بازیابی به عواملی مانند توان پردازشی سایت DR، وضعیت Replication، وابستگی سرویس ها و تنظیمات شبکه بستگی دارد.
3. استفاده بهینه از منابع سخت افزاری
- در معماری سنتی ممکن است برای هر سرویس به یک سرور فیزیکی جداگانه در سایت پشتیبان نیاز باشد.
- مجازی سازی این امکان را فراهم می کند که چندین ماشین مجازی روی یک مجموعه سرور فیزیکی اجرا شوند.
- این قابلیت می تواند هزینه تأمین سخت افزار، فضای رک، مصرف انرژی و نگهداری زیرساخت DR را کاهش دهد.
- بااین حال، میزان صرفه جویی به ظرفیت مورد نیاز و سطح سرویس دهی مورد انتظار هنگام بحران بستگی دارد.
4. خودکارسازی فرایند بازیابی
بازیابی دستی ده ها یا صدها ماشین مجازی در زمان بحران، کاری پیچیده و مستعد خطاست. ابزارهای مدیریت بازیابی می توانند بخش مهمی از این فرایند را خودکار کنند؛ از جمله:
- راه اندازی ماشین های مجازی با ترتیب از پیش تعیین شده
- اعمال تنظیمات شبکه در سایت پشتیبان
- اجرای اسکریپت های مورد نیاز
- بررسی وضعیت راه اندازی ماشین ها
- اجرای برنامه های تست بازیابی
این قابلیت باعث می شود بازیابی سرویس ها با وابستگی کمتر به اقدامات دستی انجام شود.
5. امکان آزمایش بازیابی بدون اختلال در سرویس اصلی
یکی از ارزشمندترین قابلیت های مجازی سازی، ایجاد محیط های ایزوله برای آزمایش فرایند بازیابی است. در این روش می توان نسخه های بازیابی شده ماشین های مجازی را در یک شبکه آزمایشی اجرا کرد، بدون اینکه ترافیک آن ها با محیط عملیاتی تداخل داشته باشد. این آزمایش ها مشخص می کنند که آیا سرویس ها واقعاً قابل بازیابی هستند یا صرفاً نسخه ای از داده های آن ها در سایت دیگر وجود دارد.
معماری سایت بازیابی بحران مبتنی بر مجازی سازی
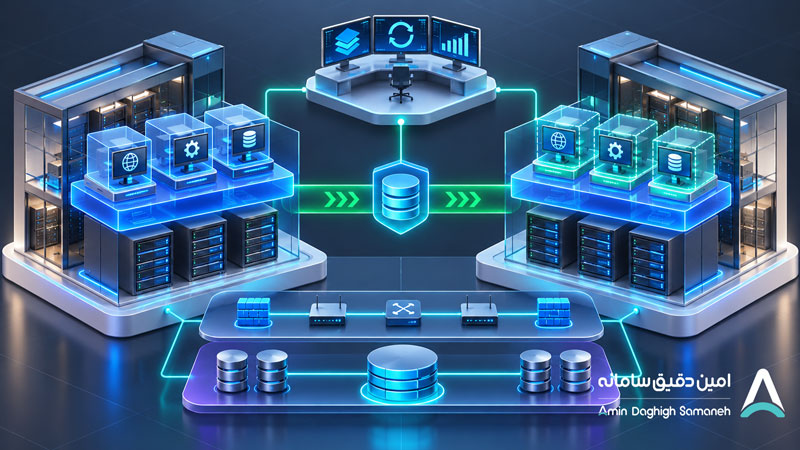
یک معماری متداول DR مبتنی بر مجازی سازی از دو بخش اصلی تشکیل می شود:
- سایت اصلی (Primary Site): محل اجرای سرویس های عملیاتی سازمان که شامل سرورهای فیزیکی، بستر مجازی سازی، ذخیره سازها، شبکه و سامانه های کاربردی است.
- سایت پشتیبان (DR Site): زیرساخت جایگزینی که ظرفیت مورد نیاز برای اجرای سرویس های منتخب سازمان را در زمان بحران فراهم می کند.
بین این دو سایت، مکانیزم Replication برای انتقال تغییرات داده و ماشین های مجازی برقرار می شود.
ساختار کلی به شکل سایت (اصلی ← ارتباط و Replication ← سایت بازیابی بحران) است.
در این معماری، معمولاً اجزای زیر مورد نیاز هستند:
| مؤلفه | وظیفه |
| Hypervisor | اجرای ماشین های مجازی |
| Management Platform | مدیریت زیرساخت مجازی |
| Replication | انتقال تغییرات داده به سایت پشتیبان |
| Storage | نگهداری دیسک ها و اطلاعات ماشین های مجازی |
| Network Infrastructure | تأمین ارتباط و مسیریابی بین سایت ها |
| Recovery Orchestration | مدیریت ترتیب و مراحل بازیابی |
| Backup System | نگهداری نسخه های مستقل و قابل بازیابی |
| Monitoring | پایش سلامت سرویس ها و وضعیت همگام سازی |
در طراحی این معماری، باید از ایجاد نقاط شکست مشترک میان سایت اصلی و پشتیبان جلوگیری شود. برای مثال، اگر هر دو سایت به یک سامانه احراز هویت یا تجهیز شبکه مشترک وابسته باشند، خرابی آن مؤلفه ممکن است بازیابی را با مشکل مواجه کند. همچنین بهتر است سامانه های مدیریتی و زیرساخت های ضروری سایت DR تا حد امکان مستقل از سایت اصلی طراحی شوند.
روش های Replication در زیرساخت مجازی
Replication یکی از اجزای کلیدی سایت DR است و وظیفه انتقال تغییرات داده از سایت اصلی به سایت پشتیبان را بر عهده دارد. انتخاب روش مناسب Replication تأثیر مستقیمی بر RPO، هزینه زیرساخت و پیچیدگی معماری دارد.
Replication هم زمان (Synchronous)
در روش هم زمان، تأیید نهایی عملیات نوشتن معمولاً به ثبت موفق داده در مقصد نیز وابسته است. این روش در صورت پشتیبانی کامل زیرساخت و رعایت الزامات طراحی می تواند RPO نزدیک به صفر فراهم کند. بااین حال، نیازمند ارتباطی با تأخیر بسیار پایین، پهنای باند کافی و زیرساخت سازگار است. به همین دلیل، استفاده از آن معمولاً برای سایت هایی مناسب تر است که فاصله شبکه ای کمی دارند و ارتباط پایدار و پرظرفیت میان آن ها برقرار است.
Replication غیرهم زمان (Asynchronous)
در روش غیرهم زمان، تغییرات داده با فاصله زمانی یا تأخیر مشخص به سایت پشتیبان منتقل می شوند. این روش انعطاف پذیری بیشتری برای استفاده در دیتاسنترهای دور از یکدیگر دارد و وابستگی کمتری به تأخیر بسیار پایین شبکه ایجاد می کند. البته در صورت بروز بحران، احتمال ازدست رفتن تغییراتی که هنوز به مقصد منتقل نشده اند وجود دارد. انتخاب میان این دو روش باید بر اساس RPO مورد انتظار، فاصله سایت ها، نوع بار کاری و ظرفیت ارتباطی انجام شود.
مراحل پیاده سازی سایت بازیابی بحران با استفاده از مجازی سازی
پیاده سازی موفق سایت DR فقط شامل نصب Hypervisor و فعال سازی Replication نیست. این فرایند باید با تحلیل نیازهای کسب وکار آغاز شود و با آزمایش عملی بازیابی ادامه پیدا کند.
مرحله اول: شناسایی سرویس های حیاتی
در ابتدا باید تمام سرویس های سازمان شناسایی و بر اساس اهمیت عملیاتی دسته بندی شوند.
برای هر سرویس لازم است موارد زیر مشخص شود:
- میزان اهمیت و تأثیر توقف آن بر کسب وکار
- RTO و RPO مورد انتظار
- وابستگی به سایر سامانه ها
- منابع پردازشی، حافظه و ذخیره سازی مورد نیاز
- الزامات امنیتی و ارتباطی
برای مثال، سامانه تراکنش مالی ممکن است نیازمند بازیابی در چند دقیقه باشد، درحالی که توقف چندساعته یک سامانه گزارش گیری برای سازمان قابل قبول باشد. این تفاوت باید در معماری DR لحاظ شود.
مرحله دوم: طراحی ظرفیت سایت پشتیبان
سایت DR باید ظرفیت کافی برای اجرای سرویس های مورد نظر را داشته باشد.
در این مرحله تعداد ماشین های مجازی، میزان CPU و RAM مصرفی، ظرفیت ذخیره سازی، نیازمندی های IOPS و پهنای باند بررسی می شود.
نکته مهم این است که سایت DR الزاماً به ظرفیت کاملاً مشابه دیتاسنتر اصلی نیاز ندارد.
اگر هدف سازمان در زمان بحران صرفاً حفظ سرویس های حیاتی باشد، می توان زیرساخت پشتیبان را بر اساس ظرفیت عملیاتی کاهش یافته طراحی کرد.
بااین حال، این تصمیم باید متناسب با سطح عملکرد قابل قبول و توانایی پاسخ گویی به کاربران اتخاذ شود.
مرحله سوم: انتخاب پلتفرم مجازی سازی و بازیابی
انتخاب فناوری مناسب به زیرساخت موجود، بودجه، سطح مهارت تیم فنی و اهداف بازیابی بستگی دارد. برخی راهکارهای متداول عبارت اند از:
- VMware vSphere: پلتفرمی برای اجرای و مدیریت ماشین های مجازی در زیرساخت سازمانی.
- VMware Live Site Recovery: راهکاری برای هماهنگ سازی و خودکارسازی فرایندهای بازیابی و جابه جایی ماشین های مجازی میان سایت ها. این محصول در مستندات و نسخه های قدیمی تر با نام Site Recovery Manager یا SRM شناخته می شود.
- Microsoft Azure Site Recovery: سرویسی برای Replication و بازیابی بارهای کاری پشتیبانی شده، از جمله برخی محیط های VMware و سرورهای فیزیکی، در زیرساخت Azure.
- Hyper-V: پلتفرم مجازی سازی مایکروسافت که در سناریوهای پشتیبانی شده می توان از قابلیت هایی مانند Hyper-V Replica برای بازیابی ماشین های مجازی استفاده کرد.
- Proxmox VE: پلتفرم مجازی سازی متن باز که با استفاده از ابزارهای پشتیبان گیری، Replication و راهکارهای مکمل می تواند بخشی از معماری DR باشد.
باید توجه داشت که قابلیت های هر پلتفرم در زمینه Replication، خودکارسازی Failover، پشتیبانی از ذخیره ساز و بازیابی بین سایت ها یکسان نیست. بنابراین انتخاب راهکار باید پس از بررسی نیازهای واقعی و امکانات نسخه مورد استفاده انجام شود.
مرحله چهارم: طراحی شبکه و ارتباط بین سایت ها
یکی از چالش های اصلی بازیابی بحران، صرفاً روشن کردن ماشین های مجازی نیست؛ بلکه برقراری ارتباط صحیح میان سرویس ها و کاربران است. در طراحی شبکه DR باید موارد زیر بررسی شوند:
- آدرس دهی IP: مشخص شود ماشین های مجازی پس از بازیابی با IP قبلی اجرا می شوند یا نیازمند تغییر آدرس هستند.
- مسیریابی: مسیر دسترسی کاربران و سایر سرویس ها به سایت پشتیبان باید مشخص باشد.
- DNS: در صورت نیاز، رکوردهای DNS باید به مقصد جدید هدایت شوند.
- Firewall Policies: قوانین امنیتی و دسترسی های ضروری باید از قبل در سایت DR تعریف شوند.
- Load Balancer: در سامانه های چندلایه، تنظیمات توزیع بار باید با معماری بازیابی هماهنگ باشند.
همچنین ارتباط Replication باید از نظر پهنای باند، تأخیر، پایداری و امنیت بررسی شود.
مرحله پنجم: پیاده سازی Replication
پس از آماده سازی زیرساخت، Replication برای ماشین های مجازی یا داده های مورد نیاز فعال می شود.
در این مرحله باید بازه همگام سازی، نقاط بازیابی و وضعیت سلامت انتقال اطلاعات کنترل شوند.
برای سرویس هایی مانند پایگاه های داده، استفاده از Replication اختصاصی دیتابیس نیز می تواند در برخی معماری ها گزینه مناسب تری باشد.
انتخاب روش صحیح به نوع سامانه و الزامات سازگاری داده بستگی دارد.
مرحله ششم: تعریف Recovery Plan
Recovery Plan مشخص می کند هنگام بحران، کدام سرویس ها و با چه ترتیبی بازیابی شوند. برای مثال، در یک سامانه سازمانی ممکن است ترتیب بازیابی به این صورت باشد:
- راه اندازی سرویس های زیرساختی ضروری مانند DNS و احراز هویت
- بازیابی پایگاه داده و بررسی سلامت آن
- راه اندازی سرورهای Application
- بازیابی وب سرورها و سرویس های ارتباطی
- اعمال تنظیمات شبکه و هدایت ترافیک
- بررسی عملکرد نهایی سامانه و تأیید توسط مسئول سرویس
این مراحل می توانند با استفاده از ابزارهای Orchestration تا حد زیادی خودکار شوند.
مرحله هفتم: اجرای تست بازیابی
پس از تکمیل پیاده سازی، باید یک سناریوی واقعی بازیابی آزمایش شود.
در این آزمایش لازم است بررسی شود که:
- آیا ماشین های مجازی بدون خطا راه اندازی می شوند؟
- آیا ارتباط میان سرویس ها برقرار است؟
- آیا اطلاعات بازیابی شده سازگار و قابل استفاده هستند؟
- آیا کاربران می توانند به سامانه دسترسی داشته باشند؟
- آیا RTO و RPO تعیین شده محقق می شوند؟
- آیا فرایند بازگشت به سایت اصلی قابل اجراست؟
نتایج این آزمایش ها باید ثبت و مشکلات شناسایی شده اصلاح شوند. سایت DR زمانی قابل اتکاست که فرایند بازیابی آن به صورت عملی و دوره ای آزمایش شده باشد.
چالش های مجازی سازی در پیاده سازی سایت DR
با وجود مزایای مجازی سازی، طراحی نادرست زیرساخت می تواند اثربخشی سایت بازیابی بحران را کاهش دهد.
محدودیت پهنای باند
حجم زیاد تغییرات داده ممکن است باعث افزایش تأخیر Replication شود. برای جلوگیری از این مشکل، باید نرخ تغییر داده ها، ظرفیت ارتباطی و حجم اولیه انتقال اطلاعات پیش از پیاده سازی بررسی شوند.
ناسازگاری داده های پایگاه داده
انتقال دیسک ماشین مجازی الزاماً به معنای بازیابی سازگار یک پایگاه داده نیست. برای سامانه های حساس باید از روش هایی استفاده شود که سازگاری تراکنش ها و وابستگی میان اجزای سامانه را حفظ کنند.
وابستگی به سرویس های زیرساختی
اگر ماشین های مجازی در سایت DR روشن شوند اما سرویس هایی مانند DNS، Active Directory یا سایر سامانه های هویتی در دسترس نباشند، ممکن است برنامه های کاربردی همچنان غیرقابل استفاده باشند. بنابراین سرویس های زیرساختی باید بخشی از برنامه بازیابی باشند.
انتقال آلودگی یا حملات باج افزاری
در صورت آلوده شدن سایت اصلی، Replication ممکن است داده های آسیب دیده را نیز به سایت پشتیبان منتقل کند. به همین دلیل، وجود بکاپ های مستقل، نسخه های غیرقابل تغییر (Immutable Backup)، جداسازی دسترسی های مدیریتی و کنترل های امنیتی ضروری است.
نبود تست منظم
یکی از مهم ترین دلایل شکست فرایند بازیابی، آزمایش نکردن سناریوهای DR است. تغییرات شبکه، افزایش تعداد ماشین های مجازی، تغییر وابستگی سامانه ها یا ارتقای نرم افزارها ممکن است برنامه بازیابی قبلی را نامعتبر کنند. بنابراین تست DR باید بخشی از فرایند نگهداری زیرساخت باشد، نه اقدامی که فقط پس از نصب اولیه انجام می شود.
آیا مجازی سازی به تنهایی برای پیاده سازی DR کافی است؟
خیر. مجازی سازی زیرساخت فنی لازم برای انتقال و بازیابی ماشین های مجازی را ساده تر می کند، اما به تنهایی یک راهکار کامل بازیابی بحران نیست.
برای ایجاد یک سایت DR قابل اتکا، علاوه بر مجازی سازی باید موارد زیر نیز وجود داشته باشند:
- برنامه مدون بازیابی بحران و تعیین مسئولیت افراد
- روش مناسب Replication و حفاظت از داده
- زیرساخت شبکه و ذخیره سازی مستقل و قابل اطمینان
- سازوکار امنیتی برای جلوگیری از گسترش حملات
- برنامه بازیابی وابستگی های نرم افزاری
- تست دوره ای و مستندسازی نتایج
در واقع، مجازی سازی یکی از مهم ترین اجزای فنی سایت DR است، اما موفقیت بازیابی به هماهنگی تمام اجزای زیرساخت و فرایندهای عملیاتی وابسته است.
جمع بندی
مجازی سازی نقش مهمی در ساده سازی و تسریع پیاده سازی سایت بازیابی بحران دارد. این فناوری با کاهش وابستگی سرویس ها به سخت افزار فیزیکی، فراهم کردن امکان Replication ماشین های مجازی، استفاده بهینه از منابع و خودکارسازی فرایندهای بازیابی، به سازمان ها کمک می کند زیرساخت DR انعطاف پذیرتر و قابل مدیریت تری ایجاد کنند. بااین حال، موفقیت سایت DR فقط به انتخاب پلتفرم مجازی سازی وابسته نیست. تعیین دقیق RTO و RPO، طراحی شبکه، حفاظت از داده ها، شناسایی وابستگی سرویس ها و اجرای تست های دوره ای از عوامل تعیین کننده در عملکرد آن هستند. یک سایت بازیابی بحران موفق، سایتی نیست که فقط نسخه ای از ماشین های مجازی را نگهداری کند؛ بلکه زیرساختی است که بتواند هنگام بحران، سرویس های حیاتی سازمان را در زمان قابل قبول و با داده های قابل اعتماد به چرخه فعالیت بازگرداند.
سوالات متداول درباره نقش مجازی سازی در بازیابی بحران
- آیا بدون مجازی سازی می توان سایت DR راه اندازی کرد؟
بله. بازیابی بحران برای سرورهای فیزیکی نیز قابل پیاده سازی است. بااین حال، مجازی سازی معمولاً انعطاف پذیری بیشتری در تخصیص منابع، انتقال بارهای کاری، خودکارسازی و بازیابی فراهم می کند. - آیا برای راه اندازی سایت DR باید تمام سرورها مجازی باشند؟
خیر. می توان از معماری ترکیبی شامل سرورهای فیزیکی، ماشین های مجازی و سرویس های ابری استفاده کرد. انتخاب روش بازیابی هر سامانه باید بر اساس نیازهای فنی و عملیاتی آن انجام شود. - آیا VMware vSphere به تنهایی امکان پیاده سازی DR را فراهم می کند؟
vSphere زیرساخت اجرای ماشین های مجازی را فراهم می کند، اما برای پیاده سازی کامل سناریوهای بازیابی بین سایت ها معمولاً به قابلیت ها یا محصولات مکمل Replication و Recovery Orchestration نیاز است. - آیا Snapshot ماشین مجازی جایگزین بکاپ یا DR است؟
خیر. Snapshot معمولاً برای ثبت وضعیت ماشین مجازی در یک مقطع زمانی و استفاده در سناریوهای مشخص عملیاتی کاربرد دارد. Snapshot به تنهایی جایگزین بکاپ مستقل یا برنامه بازیابی بحران نیست.