در بسیاری از سازمان ها وقتی تعداد قطعی ها، کندی سرویس ها یا خطاهای زیرساخت افزایش پیدا می کند، اولین راه حل پیشنهادی خرید یا راه اندازی یک ابزار مانیتورینگ شبکه است. ابزارهایی مانند Zabbix، PRTG، SolarWinds، Prometheus، Grafana و راهکارهای مشابه می توانند اطلاعات بسیار ارزشمندی درباره وضعیت شبکه و زیرساخت ارائه کنند؛ اما یک واقعیت مهم وجود دارد: خرید و راهاندازی ابزار مانیتورینگ بهتنهایی مشکلات شبکه را حل نمی کند. این ابزارها میتوانند اختلال را شناسایی کنند و درباره آن هشدار دهند، اما رفع مشکل به فرآیند مشخص، نیروی متخصص، تعریف مسئولیت و اقدام عملیاتی مناسب نیاز دارد.
اگر ندانیم چه چیزی را مانیتور کنیم، بهترین ابزار هم بیفایده است
سرویس مانیتورینگ فقط زمانی ارزش واقعی ایجاد می کند که بخشی از یک فرآیند عملیاتی منسجم باشد؛ فرآیندی که مشخص کند چه چیزی باید پایش شود، چه کسی مسئول واکنش است، چه زمانی باید اقدام شود و چگونه از تکرار مشکل جلوگیری خواهد شد.
دیدن مشکل با حل کردن مشکل تفاوت دارد
وظیفه اصلی یک سامانه مانیتورینگ، مشاهده و گزارش وضعیت است. برای مثال ابزار می تواند اعلام کند که:
- مصرف CPU یک سرور از ۹۰ درصد عبور کرده است.
- فضای یک دیسک رو به اتمام است.
- Packet Loss در یک ارتباط افزایش یافته است.
- یک Interface شبکه Down شده است.
- زمان پاسخ یک سرویس افزایش پیدا کرده است.
اما ابزار به تنهایی مشخص نمی کند چرا این اتفاق رخ داده، چه کسی باید آن را بررسی کند و چه اقدامی باید انجام شود. اگر سازمان فقط هشدار دریافت کند اما برای رسیدگی به هشدارها فرآیند مشخصی نداشته باشد، مانیتورینگ صرفاً تبدیل به یک سیستم تولید پیام خواهد شد. بنابراین فاصله بزرگی میان این دو مفهوم وجود دارد:
Monitoring → تشخیص وضعیت
Operations → مدیریت و رفع وضعیت
یک شبکه پایدار به هر دو نیاز دارد.
بی فایده بودن بهترین ابزار بدون دانش مانیتورینگ
یکی از رایج ترین اشتباهات این است که تیم فنی ابزار را نصب می کند و سپس هر Metric در دسترس را مانیتور می کند. نتیجه معمولاً صدها یا هزاران آیتم مانیتورینگ و تعداد زیادی هشدار کم ارزش است. قبل از پیاده سازی مانیتورینگ باید مشخص شود:
- سرویس های حیاتی سازمان کدام اند؟
- وابستگی میان سرویس ها چیست؟
- کدام تجهیزات Single Point of Failure هستند؟
- چه ارتباطاتی برای کسب وکار حیاتی اند؟
- چه منابعی باید از نظر ظرفیت کنترل شوند؟
- چه شاخص هایی مستقیماً بر کیفیت سرویس تأثیر دارند؟
برای مثال تنها Ping کردن یک سرور نمی تواند نشان دهد سرویس واقعاً سالم است. ممکن است سرور پاسخ Ping بدهد اما Database آن متوقف شده باشد، Application پاسخ ندهد یا Storage با تأخیر شدید مواجه باشد. مانیتورینگ حرفه ای باید از سطح تجهیزات فراتر رفته و سلامت سرویس را بررسی کند.
هشدار زیاد الزاماً به معنی مانیتورینگ بهتر نیست
یکی از جدی ترین مشکلات مراکز عملیات شبکه، پدیده ای به نام Alert Fatigue است. فرض کنید در طول یک شیفت ۵۰۰ هشدار برای تیم NOC ارسال شود. اگر بخش زیادی از این هشدارها بی اهمیت، تکراری یا ناشی از یک مشکل مشترک باشند، پس از مدتی اپراتورها حساسیت خود را نسبت به هشدارها از دست می دهند. در چنین شرایطی حتی ممکن است یک هشدار حیاتی میان ده ها پیام غیرضروری دیده نشود.
بنابراین طراحی Alerting باید شامل مواردی مانند این باشد:
- تعیین Severity مناسب
- حذف هشدارهای تکراری
- تعریف Dependency
- استفاده از Correlation
- تعیین Threshold منطقی
- Escalation بر اساس اهمیت
- ارسال Recovery Notification
- جلوگیری از ارسال هشدارهای غیرقابل اقدام
یک اصل مهم در طراحی مانیتورینگ این است: هر Alert باید به یک Action منجر شود. اگر تیم عملیات نمی داند پس از مشاهده یک هشدار چه اقدامی باید انجام دهد، احتمالاً آن Alert نیاز به بازطراحی دارد.
بدون Baseline نمی توان رفتار غیرعادی را تشخیص داد
عدد به تنهایی اطلاعات چندانی ایجاد نمی کند.
برای مثال ۷۰ درصد CPU Usage برای یک سرور ممکن است کاملاً طبیعی باشد، اما برای سروری دیگر نشانه وجود یک مشکل جدی باشد. برای تحلیل درست باید رفتار عادی زیرساخت مشخص شود. این مفهوم معمولاً با عنوان Baseline شناخته می شود.
Baseline می تواند شامل مواردی مانند:
- مصرف معمول CPU و Memory
- حجم عادی Traffic
- میزان IOPS
- Latency معمول شبکه
- تعداد Connectionها
- زمان پاسخ سرویس ها
- نرخ رشد Storage
باشد. وقتی رفتار عادی سیستم مشخص شد، تشخیص Anomaly یا تغییرات غیرطبیعی بسیار دقیق تر خواهد شد.
مانیتورینگ بدون مالک مشخص، مسئولیت ایجاد نمی کند
یکی از مشکلات رایج در سازمان ها این است که مانیتورینگ یک مشکل را تشخیص می دهد، اما مشخص نیست چه تیمی باید آن را بررسی کند. برای مثال:
- Storage Alert ایجاد می شود.
- تیم شبکه می گوید مشکل مربوط به Storage است.
- تیم Storage معتقد است مشکل مربوط به Virtualization است.
- تیم Virtualization احتمال می دهد Application باعث افزایش I/O شده باشد.
- در این شرایط ابزار مانیتورینگ کار خود را انجام داده، اما مدل عملیاتی سازمان شکست خورده است.
برای هر سرویس باید حداقل موارد زیر مشخص باشد:
- Service Owner
- Technical Owner
- تیم مسئول بررسی اولیه
- مسیر Escalation
- مسئول تصمیم گیری
- SLA رسیدگی
بدون Ownership، بسیاری از هشدارها فقط میان تیم ها جابه جا خواهند شد.
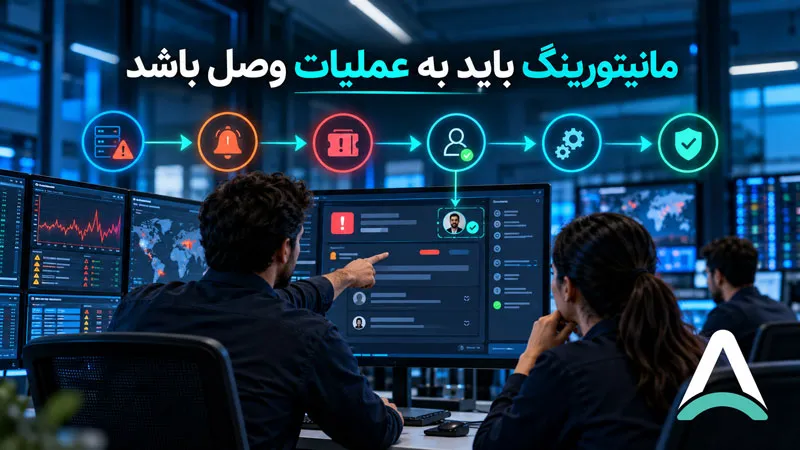
مانیتورینگ باید به Incident Management متصل باشد
در یک محیط عملیاتی حرفه ای، هشدار مهم نباید فقط در Dashboard نمایش داده شود. هشدار باید در صورت نیاز به یک Incident قابل پیگیری تبدیل شود. برای مثال:
Event → Alert → Incident → Owner → Action → Recovery → Review
در این مدل، اگر یک سرویس حیاتی Down شود:
- مانیتورینگ مشکل را تشخیص می دهد.
- Alert ایجاد می شود.
- Incident ثبت می شود.
- مسئول رسیدگی مشخص می شود.
- اقدامات انجام شده ثبت می شوند.
- سرویس بازیابی می شود.
- علت و نحوه جلوگیری از تکرار بررسی می شود.
این اتصال میان Monitoring و Service Management است که داده مانیتورینگ را به عملیات واقعی تبدیل می کند.
مانیتورینگ بدون تحلیل علت ریشه ای، سازمان را واکنشی نگه می دارد
اگر هر بار که فضای دیسک پر می شود فقط چند گیگابایت فضای جدید اضافه کنیم، مشکل ظاهراً حل شده است؛ اما علت اصلی همچنان باقی مانده است. ممکن است دلیل اصلی یکی از این موارد باشد:
- Log Rotation اشتباه
- رشد غیرطبیعی Database
- نگهداری بیش از حد Backup
- Configuration نامناسب
- Memory Leak یا Dumpهای مکرر
یک تیم بالغ فقط Incident را نمی بندد. بعد از مشکلات مهم یا تکرارشونده باید Root Cause Analysis انجام شود.
هدف اصلی باید حرکت از:
Reactive Monitoring
به سمت:
Proactive Operations
باشد.
تغییرات زیرساخت باید بخشی از مانیتورینگ باشند
بخش زیادی از Incidentهای شبکه و زیرساخت پس از یک Change ایجاد می شوند.
برای مثال:
- تغییر Firewall Rule
- Upgrade سیستم عامل
- تغییر Route
- تغییر VLAN
- Update نرم افزار
- افزایش یا کاهش منابع
- تغییر تنظیمات Storage
اگر اطلاعات Change از مانیتورینگ جدا باشد، تیم عملیات هنگام مشاهده اختلال باید زمان زیادی صرف پیدا کردن علت کند. در محیط های بالغ، تیم NOC باید بتواند ارتباط میان این دو اتفاق را مشاهده کند چه چیزی تغییر کرد؟ و بعد از آن چه چیزی خراب شد؟ به همین دلیل اتصال Monitoring به Change Management اهمیت زیادی دارد.
فقط Infrastructure Monitoring کافی نیست
امروزه بسیاری از سرویس ها از لایه های مختلف تشکیل شده اند. برای مثال یک سامانه ممکن است شامل این بخش ها باشد:
Network
→ Firewall
→ Load Balancer
→ Virtualization
→ Operating System
→ Kubernetes
→ Application
→ Database
→ Storage
ممکن است هر کدام از این اجزا به صورت مستقل Up باشند اما سرویس نهایی برای کاربر قابل استفاده نباشد. بنابراین معماری مانیتورینگ باید چندلایه باشد و حداقل شامل این حوزه ها شود:
- Network Monitoring
- Infrastructure Monitoring
- Application Monitoring
- Log Monitoring
- Service Monitoring
- Capacity Monitoring
- Availability Monitoring
هدف نهایی نباید فقط پاسخ به این سؤال باشد که سرورها روشن هستند؟ بلکه باید مشخص شود سرویسی که کاربر استفاده می کند سالم است؟
داشبورد زیبا جای فرآیند عملیاتی را نمی گیرد
Grafana Dashboard، Network Map و نمودارهای Real-Time می توانند دید بسیار خوبی ایجاد کنند، اما Dashboard به تنهایی معیار بلوغ NOC نیست. شاخص های مهم تر این ها هستند:
- یک Incident چقدر سریع شناسایی می شود؟
- چه مدت طول می کشد مسئول آن مشخص شود؟
- Mean Time to Detect چقدر است؟
- Mean Time to Repair چقدر است؟
- چند Incident تکراری وجود دارد؟
- چه میزان از مشکلات قبل از تأثیر بر کاربران شناسایی می شوند؟
- چند Alert واقعاً نیازمند اقدام هستند؟
Dashboard باید ابزار تصمیم گیری باشد، نه صرفاً صفحه ای برای نمایش نمودارها.
یک مانیتورینگ مؤثر به چه چیزهایی نیاز دارد؟
برای ایجاد یک سیستم مانیتورینگ واقعی، خرید نرم افزار تنها یکی از اجزاست. یک ساختار مؤثر معمولاً به ترکیب این موارد نیاز دارد: ابزار مناسب + طراحی Monitoring + تیم متخصص + فرآیند Incident + Ownership + SLA + Automation + تحلیل مستمر. اگر یکی از این اجزا وجود نداشته باشد، ارزش کل سیستم کاهش پیدا می کند. برای مثال بهترین ابزار مانیتورینگ جهان هم نمی تواند نبود فرآیند Escalation، مسئول نامشخص یا تیم عملیاتی ضعیف را جبران کند.
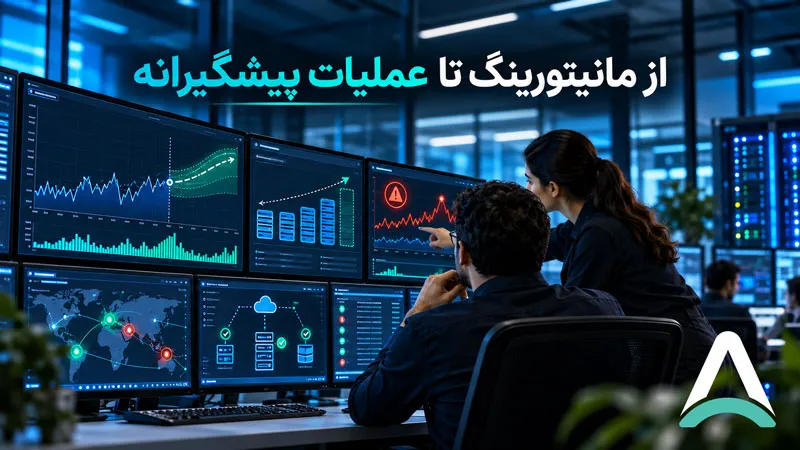
از Monitoring تا Observability و عملیات پیشگیرانه
هدف نهایی سازمان نباید صرفاً افزایش تعداد تجهیزات تحت مانیتورینگ باشد. بلوغ واقعی زمانی اتفاق می افتد که داده های مانیتورینگ برای پیشگیری از Incident استفاده شوند. برای مثال سیستم بتواند تشخیص دهد:
- فضای Storage با روند فعلی ۱۲ روز دیگر تکمیل می شود.
- Latency یک سرویس در چند هفته گذشته در حال افزایش است.
- یک لینک شبکه در ساعات مشخصی به Capacity نزدیک می شود.
- تعداد خطاهای Application بعد از یک Release افزایش یافته است.
- یک تجهیز به صورت مکرر دچار Flapping می شود.
در این نقطه مانیتورینگ از ابزاری برای مشاهده خرابی به یک سیستم تصمیم یار برای عملیات زیرساخت تبدیل می شود.
جمع بندی
خرید ابزار مانیتورینگ می تواند شروع خوبی برای مدیریت شبکه باشد، اما به تنهایی شبکه را پایدار نمی کند. ابزار فقط اطلاعات فراهم می کند. این فرآیند، نیروی متخصص، تعریف مسئولیت، مدیریت Incident، تحلیل داده و اقدام پیشگیرانه است که اطلاعات را به پایداری تبدیل می کند. سازمانی که صرفاً ابزار مانیتورینگ دارد، ممکن است مشکلات را سریع تر ببیند. اما سازمانی که Monitoring را با NOC، Incident Management، Automation، SLA و تحلیل مستمر ترکیب کرده است، می تواند مشکلات را سریع تر تشخیص دهد، سریع تر برطرف کند و مهم تر از همه، از تکرار بسیاری از آنها جلوگیری کند. به همین دلیل سؤال اصلی هنگام انتخاب راهکار مانیتورینگ نباید این باشد چه نرم افزاری بخریم؟ سؤال درست این است چطور یک فرآیند عملیاتی ایجاد کنیم که از داده های مانیتورینگ برای افزایش پایداری سرویس ها استفاده کند؟
دم شما گرمممم. به نظرم یکی از مشکلات اصلی همین هشدارهای الکی و تکراریه. وقتی روزی کلی هشدار میاد، بعد از یه مدت دیگه کسی جدیشون نمیگیره و ممکنه یه مشکل مهم هم بینشون گم بشه.
ممنون از نظر شما.
یه سوال، برای شرکتی که تازه میخواد مانیتورینگ رو جدی شروع کنه، به نظرتون اول باید روی ابزار مناسب تمرکز کنه یا مشخص کردن فرایند رسیدگی به مشکلات؟
سلام خدمت شما، به نظر ما اول باید فرآیند رسیدگی به مشکلات مشخص بشه، بعد ابزار متناسب با نیاز انتخاب بشه. چون مانیتورینگ مؤثر فقط شناسایی مشکل نیست بلکه واکنش سریع و درست به اونه.